浙江数字医疗卫生技术研究院OMAHA欢迎您!

目前国内医院病案统计和医保报销主流在用的编码为ICD-10或其相关扩展版,大多数数据统计分析需要处理成千上万的临床疾病诊断。当前人工编码成本较高,利用计算机处理的方式直接将临床疾病诊断匹配至ICD-10能力受限。再者,目前医院病历数据缺乏标准,不同医院、地区甚至医院内不同系统的数据处理方式方法不同,相关经验难以复用。
OMAHA 于2019年1月份正式面向行业开放ICD-10编码API,旨在帮助企业获得快速且有效的ICD-10编码服务,在过去的两个月内,我们对ICD-10编码方案进行了更新迭代,编码效果又有了质的提升,当前真实世界诊断编码准确度可达97%。
ICD-10编码服务能够实现高精确性的背后,是由多个术语资源来支撑,其中包括OMAHA七巧板医学术语集、ICD-10编码术语集等,所有调用的数据资源均已完成语义层面的归一。
OMAHA七巧板医学术语集:将真实世界临床在用的医学术语基于本体框架模型进行梳理,形成临床医学术语知识图谱。目前已经收录100万术语,254万关系(层级关系、属性关系),其中疾病诊断相关术语有18万,覆盖80%以上常用疾病领域的医学术语并将持续进行维护更新。
本体映射引擎:OMAHA自主研制开发的本体映射引擎,可以从语义层面理解真实世界医学术语。
ICD-10编码术语集:收录整理了覆盖全国省、直辖市在用的14个ICD-10扩展版,并对所有版本进行语义层面归一。
ICD-10编码服务通过与自主研发的ICD-10编码术语表和七巧板医学术语集间的概念层面的映射关系,实现精确编码,并通过本体映射引擎等一系列方式进行推荐编码作为补充。通过真实数据测试,目前精确编码比例为92%,推荐编码比例为8%。
精确编码:将外来诊断名称与OMAHA七巧板医学术语集进行匹配,借助术语集与ICD-10编码术语表的映射关系、知识图谱等,将疾病诊断准确编码至ICD-10,并依托ICD-10编码术语集实现不同版本间的转码。
推荐编码:对于暂未收录的疾病诊断术语,通过本体映射引擎匹配至语义相似度最高的OMAHA医学概念上,再借助术语集与ICD-10编码术语表的映射关系实现编码。
相信之前使用过 ICD-10编码API的朋友已经发现了我们本次更新后的版本与第一版的最大区别在于,收录了更多的扩展版。没错,我们对全国各省、直辖市(港澳台除外)医院进行了调研,收集与整理了全国在用的所有ICD-10扩展版,基于对编码名称的语义理解的前提下,将14个扩展版32万编码进行了语义层面的概念归一,最终形成了3.8万个医学概念。
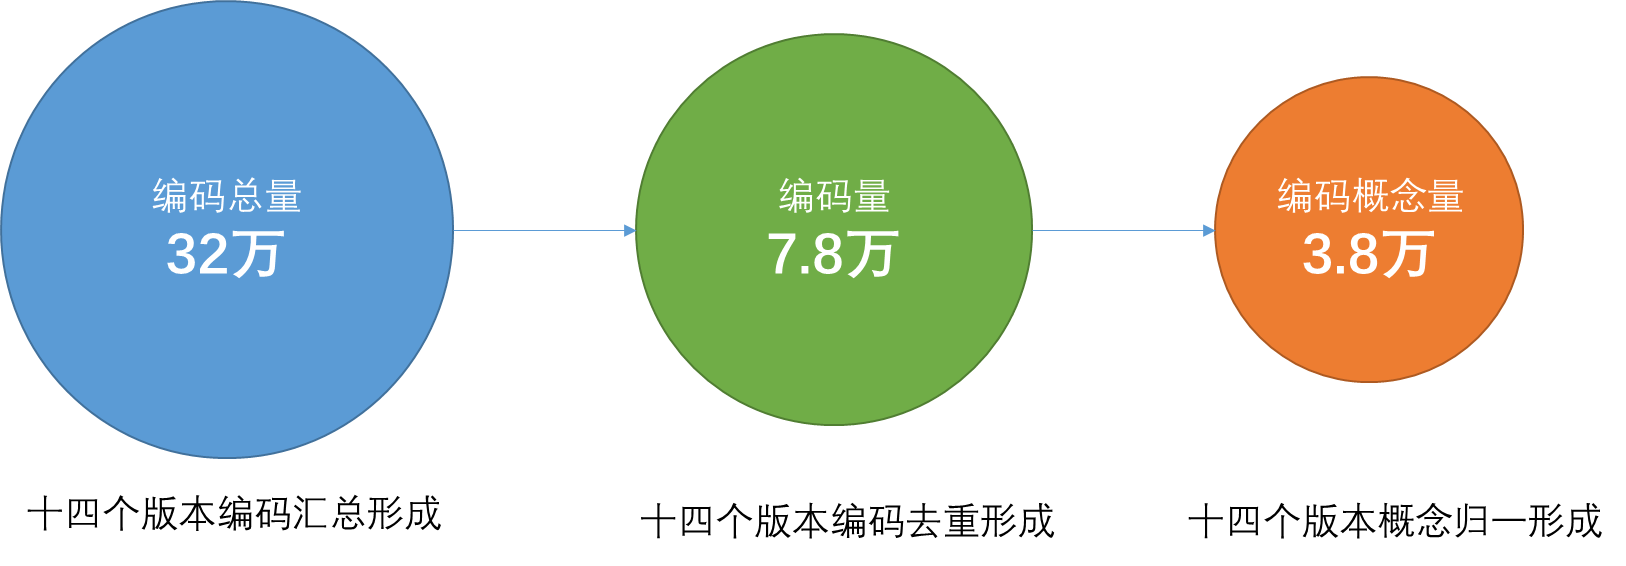
也就是说只要编码至一个版本,根据ICD-10编码术语集实现与他版本的转码。以下是我们收集的14个ICD-10扩展版本:
1. 国家标准版1.1
2. 国家版GB/T 14396-2016
3. 国家临床版1.1
4. 北京临床版ICD-10 V6.01
5. 国家标准版1.0
6. 疾病分类与代码(2011年修订版)
7. 疾病分类与代码全国1.3版
8. 2013上海ICD-10更新版
9. 全国版RC020-1CD-10诊断编码
10. 北京版RC020-1CD-10诊断编码
11. 北京市疾病诊断名称与代码标准V5.0版本
12. 广东省ICD-10疾病分类与代码(2017年版本)
13. 国家临床版1.0
14. 山东省济南市卫生信息数据共享与交换规范值域代码:ICD10编码
◆ ◆ ◆
你所不知道的ICD-10扩展版的那些事
面对这么多ICD-10扩展版本,在进行快(虐)乐(心)的整理时,OMAHA君脑洞大开,试着将14个扩展版进行了分析比对,发现了一些很有趣的数据,今天就来给大家扒一扒那些关于ICD-10扩展版你所不知道的那些事儿~
“颗粒度最细”版本:国家临床版1.1
“颗粒度最粗”版本:国家标准版1.0
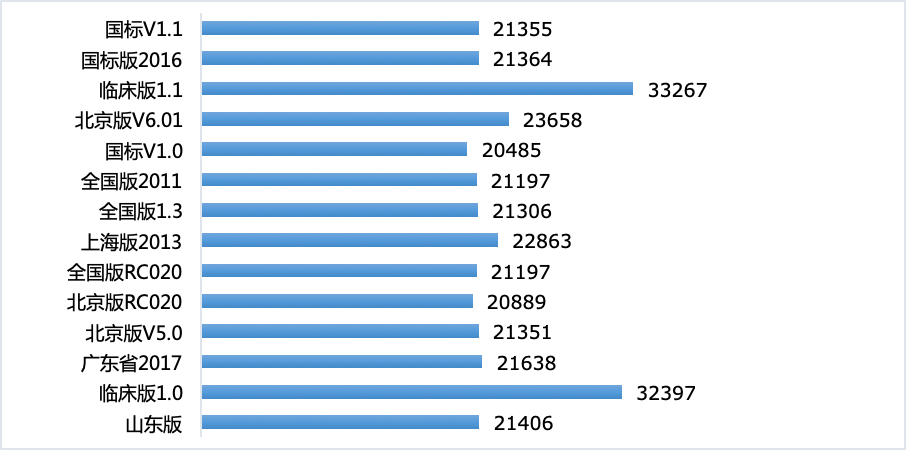
目前14个扩展版一共有32万个编码,平均每个版本有2.3万个编码,其中国家临床版1.1的编码量最多,有3.3万,而国家标准版1.0的编码量最少,只有2.0万,各版本编码量详见图一。经过小伙伴逐一验证,发现结果正如我们所想的编码数量越多的版本术语颗粒度越细。
图一:各个版本编码量
“最与众不同”版本:北京临床版ICD-10 V6.01
14个扩展版中编码不一致或编码名称不一致的数量有7.3万,我们对各个版本之间相同的编码进行了统计,发现14个版本编码和名称同时相同的编码数量只有719个,不到编码量的1%。这个比例让OMAHA君感到惊讶,14个版本之间差异性如此之大,是什么原因造成的呢?
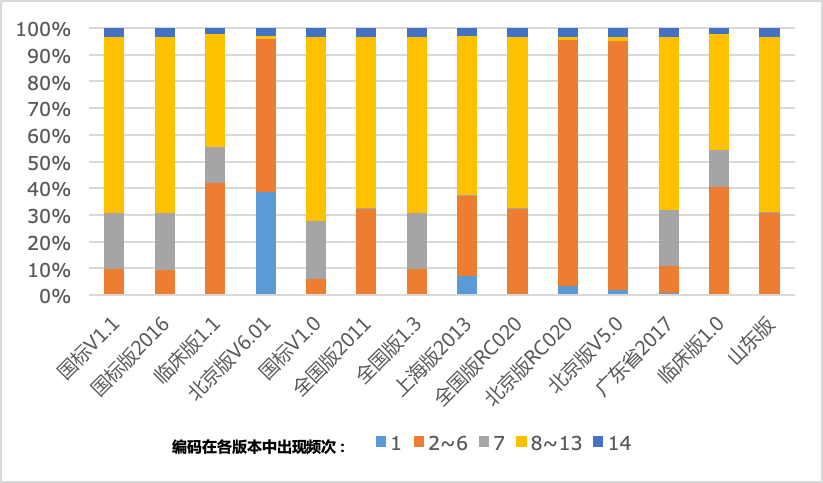
我们将单个扩展版的编码与所有版本的编码比对,进行了构成分析(如国标版v1.1中编码A及编码名称在其他13个版本内存在计数为14,以此类推),各版本间编码及其编码名称均相同的计数分布情况(详见图二),发现大多数版本之间相同的编码并没有想象中的那么多,其中11个版本一致性的编码数量有18%之多,是谁在破坏内部的一致性?北京临床版ICD-10 V6.01,它独有的编码量就有9115个。这可能是由于北京版研制的初衷就是为了服务临床诊断而不是病案编码统计而造就了它的与众不同,也导致了我们版本一致性分析结果的百分比如此之低的原因。
图二:各版本间编码及其编码名称均相同的计数分布情况
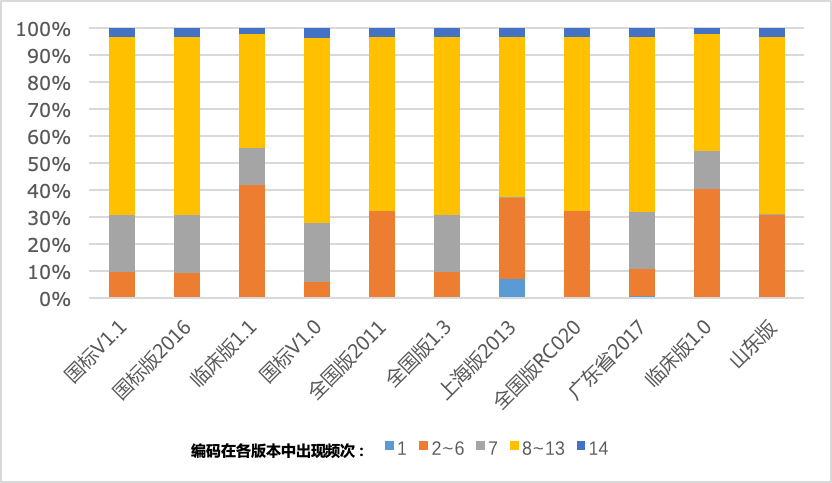
北京的几个扩展版与其他的版本差异较大,导致整体结果产生偏差。于是,我们将北京的3个版本剔除后再进行分析,各版本间(北京各版本除外)编码及其编码名称均相同的计数分布情况(详见图三),发现版本之间编码和名称的一致性上升至33.1%,但差异性仍然较大,各个版本之间直接转换的成本依旧非常高。
图三:各版本间(北京各版本除外)编码及其编码名称均相同的计数分布情况
“被扩展码最多”的编码:C79.8
我们对四位码的拓展编码数量进行了分析,平均每个四位码有18个扩展码(中位数),不同的四位码拓展码数量差异非常巨大,有些四位码一个扩展码都没有,而有些四位码下却又数百个拓展码,其中“C79.8,其他特指部位的继发性恶性肿瘤”这个四位码下竟然有752个扩展码(具体排序详见表一)。根据结果发现,被扩展最多的四位码主要是没有明确指向具体疾病的编码。
表一:四位码被扩展次数排序
排序 | 四位码 | 名称 | 扩展编码数量 |
1 | C79.8 | 其他特指部位的继发性恶性肿瘤 | 752 |
2 | A18.0 | 骨和关节的结核 | 692 |
3 | K91.8 | 消化系统的其他操作后疾患,不可归类在他处者 | 622 |
4 | D18.0 | 血管瘤,任何部位 | 609 |
5 | N28.8 | 肾和输尿管其他特指的疾患 | 531 |
编码员“最常搜索”的诊断:肺炎
另外,我们对OMAHA微信小程序中ICD-10的搜索进行了词频统计,发现搜索频率最高的医学术语依次为:肺炎、高血压、冠心病、糖尿病和脑梗死,这些都是常见疾病。
编码员“最头疼”的诊断
临床上有些诊断与对应的ICD-10编码名称相差甚远,这需要编码员需要有相关的医学背景知识,才能对这些诊断进行正确的ICD编码。比如,2型糖尿病这个诊断,需要匹配到的编码是E11:非胰岛素依赖型糖尿病;鹅口疮需要匹配到的编码是B37.0:念珠菌性口炎。我们的ICD-10编码小程序可以支持识别这些有别于编码名的临床表达,帮助编码员快速编码。
非常感谢三年来近七万编码员对OMAHA ICD-10编码小程序的认可与支持!
◆ ◆ ◆
API申请方式
目前在HiTA术语服务平台已开放申请通道。
进入OMAHA官网,点击"HiTA"—“HiTA 术语”,通过“ICD编码API”即可进入申请页面。
第一步:申请ICD-10编码API;
第二步:审核通过后接收KEY;
第三步:立即使用。
联系方式:hita@omaha.org.cn
扫码关注OMAHA公众号

扫码添加官方微信
联系方式:
电话:0571-88983625
邮箱:us@omaha.org.cn
办公地址:
浙江:杭州市余杭区良渚文化村设计路8号
重庆:重庆市两江新区平和路5号中瑞产业园
山西:太原市迎泽区亚佳大厦

 服务咨询
留下您希望了解的内容,我们将尽快与您联系
 建议与反馈
分享您的使用感受和建议,帮助我们持续改进
在线咨询
电话0571-88983625
邮箱us@omaha.org.cn


